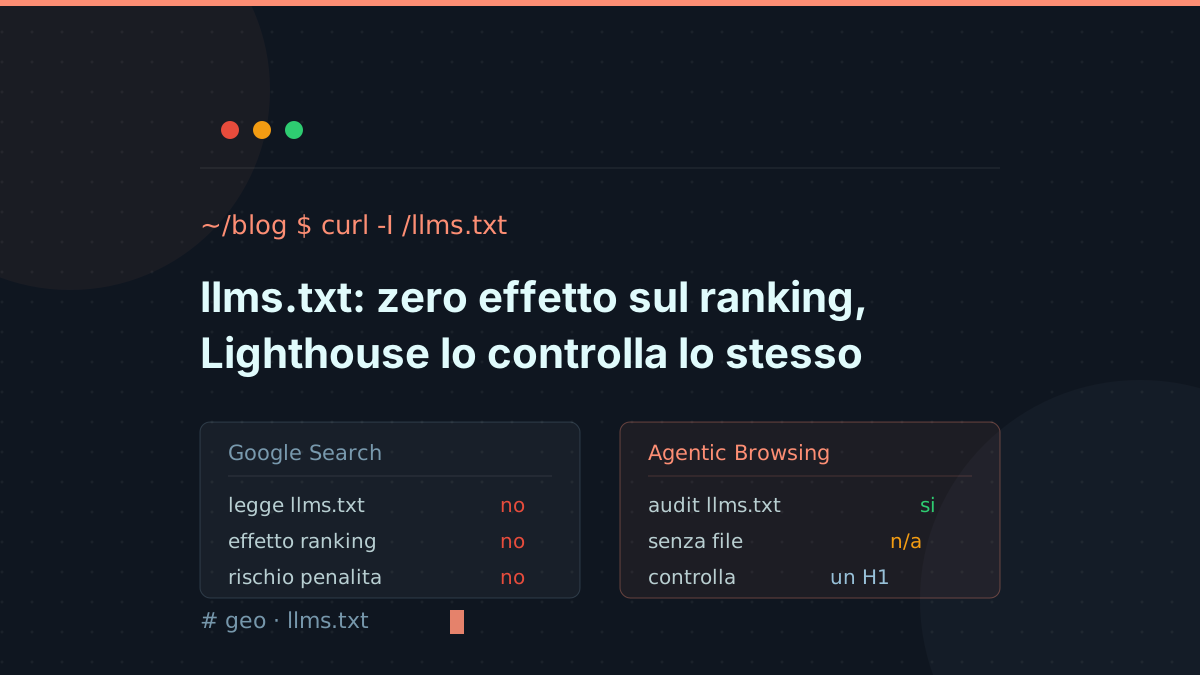
llms.txt: inutile per il ranking, ora Lighthouse lo controlla
llms.txt non ha effetti su ranking e AI Overviews, lo dice Google. Intanto Lighthouse lo audita per gli agenti: cosa cambia davvero e cosa costa il file.
Su llms.txt sono arrivate due notizie a poche settimane di distanza e sembrano dire il contrario l’una dell’altra. Google ha messo nero su bianco che il file non ha nessun effetto sul posizionamento, in nessuna direzione. Chrome, dall’altra parte, ha aggiunto a Lighthouse una categoria sperimentale che quel file lo cerca e lo verifica. Chi vende consulenza ha usato la seconda per rimettere in vita la prima.
Non è una contraddizione, e la ragione è noiosa: si tratta di due sistemi diversi, con due scopi diversi, che guardano il tuo sito per motivi diversi. Uno lo indicizza per rispondere a una query. L’altro ci deve navigare dentro per conto di qualcuno. Qui sotto trovi dove finisce il primo e comincia il secondo, cosa dicono esattamente le due fonti ufficiali, e il risultato dell’audit eseguito sul mio sito, che un llms.txt ce l’ha da giorni.
Google Search non legge llms.txt: cosa dice la guida ufficiale
La fonte è una sola e va letta letteralmente. Nella guida di Google sulle funzionalità AI in Search, sezione “Mythbusting generative AI search: what you don’t need to do”, la frase è questa: “You don’t need to create new machine readable files, AI text files, markup, or Markdown to appear in Google Search (including its generative AI capabilities), as Google Search itself doesn’t use them”.
Poi c’è la parte che quasi nessuno cita e che è la più importante per chi il file ce l’ha già: “Doing so will neither harm nor help your site’s visibility or rankings in Google Search, as Google Search ignores them”. Ho verificato la pagina il 20 agosto 2026: riporta come ultimo aggiornamento il 10 luglio 2026.
Le due frasi insieme chiudono due discussioni contemporaneamente. La prima chiude quella di chi vende llms.txt come leva di visibilità, anche nella versione più aggiornata dell’argomento, quella che promette di finire negli AI Overviews e in AI Mode: non lo è, e non perché sia poco efficace, ma perché il sistema non legge il file. La frase copre esplicitamente le capacità generative della Search, quindi non resta scoperto nemmeno quel fronte. La seconda chiude quella opposta, cioè di chi ha cominciato a consigliare di rimuoverlo per paura di una penalizzazione: non esiste un rischio, perché Google lo ignora. Un file ignorato non è un file punito.
Vale la pena notare la formulazione, che è insolitamente netta per la documentazione Google. Non dice “non è necessario”, che lascerebbe aperto il dubbio del piccolo vantaggio. Dice che la Search non li usa. È una dichiarazione di assenza di lettura, non di scarso peso, e chiude anche la variante furba dell’argomento, quella del “male non fa, magari intanto”.
🛠️ Cosa controlla davvero l’audit Agentic Browsing di Lighthouse
Qui cambia lo strumento e cambia il committente. Lighthouse è il motore di audit di Chrome, quello che gira in DevTools e dentro PageSpeed Insights, e non ha voce in capitolo sul ranking: misura pagine, non le posiziona. La categoria Agentic Browsing è la novità, ed è dichiarata sperimentale in modo esplicito: “The Agentic Browsing category and WebMCP support are experimental and based on proposed standards”.
La differenza più significativa rispetto alle altre categorie sta nel punteggio, che non c’è. Non produce il classico numero da 0 a 100 pesato, ma una frazione di controlli superati, perché lo scopo dichiarato in questa fase è raccogliere dati e dare segnali azionabili, non stilare una classifica. Chi ti mostra uno screenshot con un punteggio agentico da migliorare sta guardando un contatore, non un voto.
Gli audit della categoria sono quattro famiglie: l’integrazione WebMCP (tool registrati, validità degli schema, form privi di copertura dichiarativa), l’accessibilità pensata per gli agenti (nomi programmatici degli elementi interattivi e integrità dell’albero di accessibilità), la stabilità di layout misurata col Cumulative Layout Shift, e la scopribilità, dove sta llms.txt.
Sul singolo audit la documentazione dedicata è precisa su un punto che ribalta l’aspettativa di molti: “If the file is not provided by the server (resulting in a 404), the audit is marked as Not Applicable (N/A), as providing the file is optional at the moment”. Tradotto: se non hai llms.txt, l’audit non ti boccia. Non risulta rosso, risulta non applicabile. Quello che viene segnalato è il caso opposto, cioè un errore del server nel recuperare il file, che è un problema di configurazione e non di contenuto.
Il test sul mio sito, il 20 agosto 2026
Questa parte l’ho eseguita invece di raccontarla. Il mio llms.txt è online dal 18 agosto, quindi il sito è un banco di prova legittimo. Comando, da terminale, con Lighthouse 13.4.1 su Chrome headless 151:
npx lighthouse https://www.enricomorano.it/ \
  --only-categories=agentic-browsing \
  --output=json --output-path=lh.json
Il risultato, letto dal JSON invece che dal report grafico, dice quattro cose. La categoria agentic-browsing esiste ed è interrogabile da CLI, senza attendere aggiornamenti. L’audit llms-txt restituisce score: 1 in modalità binaria, quindi passato. agent-accessibility-tree e cumulative-layout-shift passano anche loro. I tre audit WebMCP escono tutti come notApplicable, perché il sito non registra nessun tool WebMCP, che è la condizione normale del 99,9% dei siti oggi.
Il dettaglio che vale l’intero articolo sta nella descrizione dell’audit dentro il report, che è più esplicita della documentazione: “The llms.txt file should be a Markdown file containing at least one H1 header”. Il titolo dell’audit è “llms.txt follows recommendations”, ma il controllo effettivo è quello. Lighthouse non giudica la qualità del tuo llms.txt: verifica che sia Markdown e che contenga almeno un H1. Un file con una riga di titolo e nient’altro passa esattamente come il mio, che ne ha ottantanove.
L’audit si chiama “llms.txt follows recommendations”, ma la soglia reale è un H1 in un file Markdown. Passarlo non significa avere un buon llms.txt, significa averne uno sintatticamente valido.
Una nota di onestà sulla maturità dello strumento, perché serve a calibrare le aspettative. A giugno 2026 è stata aperta la issue 17082 su GoogleChrome/lighthouse: su PageSpeed Insights l’audit segnalava “Fetch of llms.txt failed” per file conformi alla specifica che rispondevano regolarmente 200, perché PSI girava su Chrome 146 mentre la categoria ne richiede 150 o superiore. L’issue è chiusa con una pull request correlata, ma il punto resta: un audit sperimentale può darti un falso rosso per ragioni che non hanno niente a che vedere col tuo sito. Se lo vedi fallire, la prima cosa da controllare è la versione di Chrome dello strumento, non il file.
Perché non è una contraddizione: ranking e agent readiness
Il modo più rapido per uscire dall’apparente conflitto è smettere di chiedersi chi ha ragione e chiedersi chi sta guardando. Sono due modelli di interazione distinti e non comunicano fra loro.
Nel primo un motore di ricerca acquisisce le tue pagine, le indicizza e le usa per costruire una risposta, che sia un elenco di link o un riassunto generativo. Il committente della visita è il motore, il tuo sito è materia prima e la tua pagina compete con altre. Qui llms.txt non entra, perché Google dichiara di non leggerlo, e non ci sono margini interpretativi.
Nel secondo un agente arriva sul tuo sito per conto di una persona con un compito da svolgere: trovare un prezzo, compilare un modulo, verificare una disponibilità, capire se offri un servizio. Non deve classificarti fra mille alternative, deve capire come sei fatto e usarti. Il post di Chrome che presenta gli strumenti per rendere un sito agent ready lo dice in una riga che vale la pena leggere due volte: “When agents are just searching for websites, the principles for Search Engine Optimization still apply”. Cioè: la SEO copre il caso in cui l’agente ti cerca; l’agent readiness copre il caso in cui l’agente ti usa.
Da qui discende la conseguenza pratica che interessa a un’azienda. La domanda giusta non è “llms.txt serve”, che è mal posta, ma quale dei due modelli riguarda il mio sito. Un sito vetrina che vive di ricerche informative sta quasi tutto nel primo caso. Un e-commerce, un configuratore, un portale con area riservata o un servizio con prenotazione online cominciano ad avere una quota reale di traffico nel secondo, e quella quota crescerà. Chi vende ricambi con schede tecniche fitte è già oggi un candidato naturale a essere consultato da un agente per conto di un cliente.
Su questo il quadro largo l’ho scritto in cos’è la GEO, dove llms.txt compare fra i punti che Google elenca come non necessari, e nella checklist dei contenuti per AI Mode. La linea non cambia con questa notizia, si precisa: resta fuori dalla Search, e acquista un senso circoscritto fuori da lì.
✅ File llms.txt: come si fa, secondo la proposta originale
La specifica è una sola e sta su llmstxt.org. La proposta è di Jeremy Howard, pubblicata il 3 settembre 2024, e la versione oggi in vigore è la v2, modificata il 10 agosto 2026. L’obiettivo dichiarato è “A proposal to standardise on using an /llms.txt file to provide information to help agents use a website”: la parola chiave è use, non rank, ed era già lì due anni fa.
Il file va alla radice del dominio, /llms.txt, ed è ammesso anche in un sottopercorso tipo /docs/llms.txt. Il formato è Markdown con una struttura ordinata: un H1 col nome del progetto, che è l’unica sezione obbligatoria; un blockquote con una sintesi breve; sezioni libere opzionali con i dettagli; e infine H2 dedicati che contengono liste di link, dove ogni voce è un collegamento Markdown seguito facoltativamente da due punti e da una nota.
Il mio, per essere concreto, sta in 89 righe e 6.578 byte, viene servito con content-type: text/plain e segue quello schema: H1 col nome, blockquote con la descrizione in una riga, poi H2 su chi sono, servizi, stack, progetti, modalità di lavoro, e in fondo la lista dei link alle pagine principali. Il tempo per scriverlo è stato quello di riassumere cose che stavano già sul sito. Non ho aggiunto una riga di contenuto nuovo: ho reso navigabile in un colpo solo quello che esisteva già sparso in sei pagine.
Due errori che vedo fare spesso. Il primo è generare llms.txt automaticamente riversandoci dentro l’intero contenuto del sito: diventa un file enorme, che nessuno legge in una passata e che nessuno aggiorna, cioè l’opposto dello scopo. Il secondo è lasciarlo invecchiare: un file che elenca servizi che non offri più danneggia più dell’assenza del file, perché fornisce a un agente informazioni sbagliate con l’autorevolezza della prima persona.
Quanto costa e quando ha senso per una PMI
Il costo del file, per un sito già esistente e con contenuti scritti, è nell’ordine di mezz’ora. Non ci sono moduli da comprare, non ci sono canoni, non ci sono dipendenze. Su un sito statico è un file in public/; su PrestaShop o su un hosting classico è un file di testo caricato nella root, e finisce qui.
Il vero costo è un altro ed è ricorrente: la manutenzione. Aggiornarlo quando cambiano servizi, pagine chiave o contatti, cioè due o tre volte l’anno. Vale la pena metterlo a preventivo solo insieme a quella riga, altrimenti fra diciotto mesi hai un documento che descrive un’azienda che non esiste più.
Il criterio che uso con i clienti sta in due domande. Il sito ha un compito che qualcuno potrebbe voler far svolgere a un agente al posto suo, tipo cercare un prodotto, confrontare specifiche, prenotare, richiedere un preventivo? Se la risposta è affermativa, il file rientra nella manutenzione ordinaria, insieme a cose che pesano di più come una struttura HTML pulita, form etichettati bene e un layout che non salta. Se invece il sito è una vetrina di cinque pagine che vive di ricerche informative, il file resta facoltativo: mettilo se ti va, non aspettarti effetti misurabili nel breve, e soprattutto non pagarlo come se fosse un intervento SEO.
Quello che non va fatto, in nessuno dei due casi, è comprarlo per il ranking. Non va fatta neanche la mossa opposta, cioè toglierlo in fretta e furia: Google lo ignora, non lo penalizza, e chi ti consiglia di rimuoverlo per prudenza sta inventando un rischio che la documentazione esclude in modo esplicito. Sul tema del controllo degli accessi, che è la domanda che segue sempre questa, vale il discorso che ho fatto in bloccare le AI dal robots.txt: llms.txt non è uno strumento di blocco e non è mai stato pensato per esserlo.
Cosa mi porto a casa
La sintesi in tre righe. Per la Search di Google llms.txt non esiste, e la documentazione lo dice con una formulazione che non lascia spazio: il file non viene usato, quindi non aiuta e non danneggia. Per il browser il file è entrato in un audit sperimentale che ne verifica la sintassi minima, e la sua assenza non produce un fallimento ma un non applicabile. Fra i due piani non nasce nessun conflitto: cambiano il committente della visita e lo scopo.
Il mio consiglio operativo è quello che applico al mio sito: il file c’è, è scritto a mano, è corto, punta alle pagine che contano, e non compare in nessun preventivo alla voce visibilità. Se ti interessa il quadro completo di cosa sposta davvero le citazioni nelle risposte generative, e cosa invece viene venduto come leva senza esserlo, è il lavoro che faccio nella consulenza GEO.
❓ Domande frequenti
llms.txt serve per il posizionamento su Google?
Se ho già un file llms.txt sul sito devo rimuoverlo?
Cosa controlla esattamente l'audit llms.txt di Lighthouse?
Come si esegue il controllo agentic browsing sul proprio sito?
Che differenza passa fra ottimizzare per la ricerca e per gli agenti?
Quanto costa fare un file llms.txt e cosa deve contenere?
Hai un progetto in testa?
Raccontami cosa ti serve o cosa non funziona. Rispondo entro 24 ore, senza preventivi a scatola chiusa.