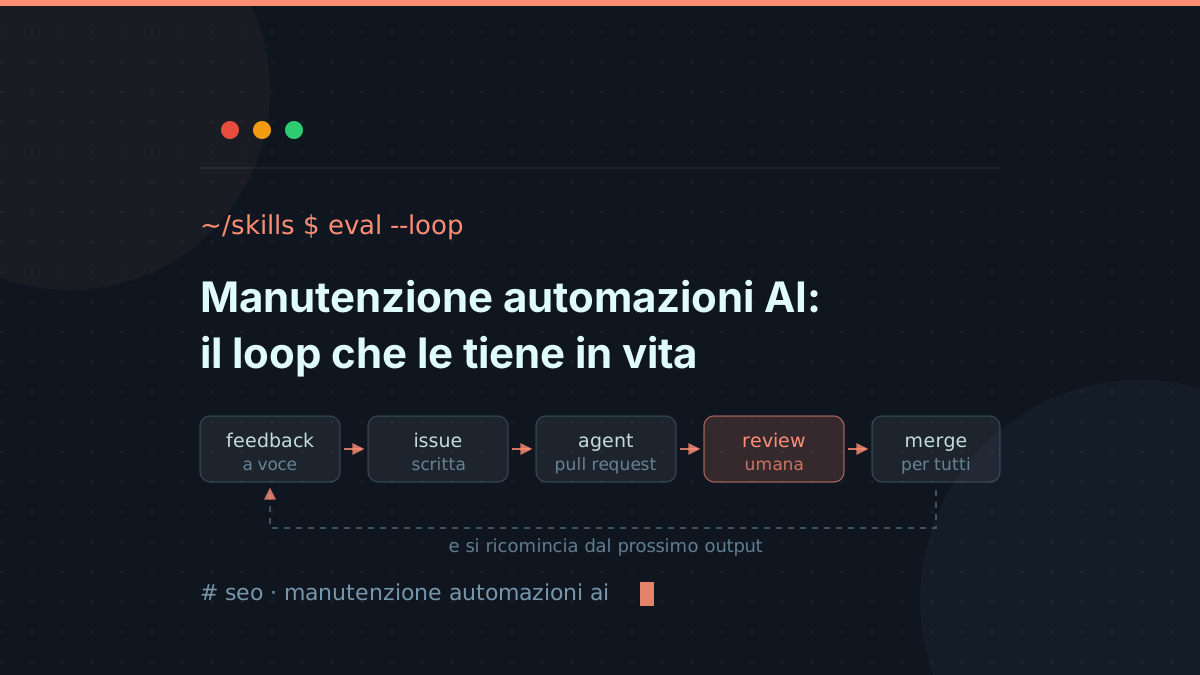
Manutenzione automazioni AI: il loop che le tiene in vita
Manutenzione automazioni AI: come ci si accorge che uno script o una skill hanno smesso di funzionare, quanto restano rotti in silenzio e il loop che li ripara.
Manutenzione automazioni AI vuol dire una cosa sola: accorgersi che uno script, un controllo o una skill hanno smesso di fare quello che credevi facessero, e accorgersene prima che il danno finisca in pagina. Qualche giorno fa ho messo per iscritto cosa automatizzo davvero sui siti che seguo. Questo pezzo è il seguito naturale, e parla della metà che nessuno mette nel preventivo: come si tiene in vita quella roba dopo il primo mese.
Il motivo per cui vale la pena scriverlo adesso è che qualcuno ha finalmente pubblicato il meccanismo per intero. Il 20 agosto Seer Interactive ha raccontato il loop con cui migliora le proprie skill aziendali, e leggendolo mi sono reso conto che la stessa forma la uso anch’io da mesi, solo in versione artigianale e senza chiamarla in nessun modo.
Perché un’automazione smette di funzionare senza dirtelo
Un guasto rumoroso non è un problema: lo script va in errore, il build si ferma, la notifica non arriva e te ne accorgi la sera stessa. Il guasto che costa è l’altro, quello che lascia tutto verde mentre sotto non succede più niente.
Le forme sono tre e le ho viste tutte e tre in casa mia. La prima è la regressione silenziosa: il controllo gira, restituisce esito positivo e non ha guardato niente.
La seconda è lo spostamento del mondo attorno: il codice è identico a sei mesi fa, ma la pagina che leggeva ha cambiato struttura, l’endpoint ha cambiato formato, la regola editoriale che verificava non è più quella. La terza è il giudizio che si allarga: vale solo per gli strumenti che chiamano un modello, e consiste nel fatto che lo strumento decide caso per caso quanto essere pignolo, quindi funziona quasi sempre e fallisce senza schema riconoscibile.
Nessuna delle tre produce un messaggio di errore. Tutte e tre producono un output che sembra normale, e questa è esattamente la ragione per cui la manutenzione di questa roba non si può fare a sensazione.
⚠️ Quanto restano rotte: sei guasti veri con il tempo di scoperta
Gli episodi li ho già raccontati uno per uno nel pezzo sulle automazioni, quindi qui non li ripeto: li rimetto in fila su un asse diverso, l’unico che conta per la manutenzione. Non “cosa si è rotto”, ma quanto tempo è rimasto rotto e chi lo ha visto per primo. Sono tutti annotati con la data nel diario di lavoro il giorno stesso.
| Guasto | Come si presentava | Tempo di scoperta | Cosa ha chiuso il loop |
|---|---|---|---|
| Verifica accenti che passava tutto (12/07) | build verde, esito positivo su ogni file | mesi | rilettura del codice, non un fallimento |
| Stessa verifica, falso positivo su un URL (12/08) | pubblicazione bloccata a torto | immediato | eccezione sugli indirizzi web |
| Numeri inventati da un agent sulla cover (13/07) | due cifre plausibili sul catalogo del cliente | subito, per conoscenza diretta | regola: ogni numero con la sua fonte |
| Attribuzione slittata in prima persona (11/08) | frase corretta, esperienza non mia, e un “20-30%” assente nella fonte | in revisione, prima della pubblicazione | doppia review, una tecnica e una editoriale |
| Comando di console inesistente in bozza (05/08) | procedura verosimile e mai eseguita | in revisione | riscontro alla documentazione ufficiale |
| Sub-agent fermo a 272k token senza produrre il file (14/08) | nessun output, tre blocchi consecutivi | immediato, costo già pagato | cambio di metodo, non di prompt |
Le due righe che contano sono la prima e l’ultima. La prima perché il tempo di scoperta si misura in mesi e nessuna macchina lo ha ridotto: quel difetto lo ha trovato una rilettura umana, per caso. Il controllo terminava in silenzio con esito positivo per un difetto nella scrittura del suo output, e in più il formato su cui scrivo gli articoli non rientrava nemmeno nell’elenco dei file sorvegliati. Un controllo rotto è peggio di un controllo assente, perché ti fa smettere di guardare.
L’ultima riga è il caso opposto e più istruttivo, perché il guasto non stava nello strumento ma nel modo in cui lo stavo usando. Un sub-agent incaricato di scrivere un articolo ha bruciato 272.000 token senza produrre il file: veniva respinto tre volte dal controllo sugli accenti e non riusciva a capire dove fosse l’errore, perché il messaggio elenca la categoria del problema e non l’occorrenza. Il fallimento era visibile subito, il che lo rende un guasto buono. La cosa interessante è il fix, che non è stato scrivere un prompt migliore.
Il tempo di scoperta è la sola metrica di manutenzione che conta. Un guasto trovato in dieci secondi è un fastidio, lo stesso guasto trovato dopo tre mesi ha già firmato del lavoro al posto tuo.
🛠️ Il loop di Seer: dal feedback vocale al merge per tutta l’azienda
La versione formalizzata di questo ciclo l’ha pubblicata Seer Interactive, agenzia americana da oltre duecento persone, in un pezzo firmato da Wil Reynolds e Jordan Strauss il 20 agosto: how we built an agentic loop to improve every skill in our company. Vale la pena leggerlo alla fonte, perché è uno dei pochi racconti di processo con i numeri di riferimento dentro invece che una promessa generica.
Il meccanismo che descrivono ha cinque passi. Una persona valuta l’output di una skill, e per farlo la strada più rapida è parlare a voce. La registrazione viene trascritta e trasformata in una issue GitHub strutturata, con Claude usato proprio per convertire il discorso libero in un elenco di problemi.
Un agent riceve la issue, la lavora dall’inizio alla fine e apre una pull request. Un umano decide se quella modifica va in produzione. Se la approva e la fonde, la modifica arriva a chiunque userà quella skill la volta dopo, perché nella loro impostazione i commit del repository si propagano ai plugin Claude di tutta l’azienda.
Nel caso che raccontano, Reynolds ha valutato la skill di analisi dei cali di traffico girata sul sito dell’agenzia. Nove minuti di feedback registrato, quattro problemi reali trovati: una cifra di traffico presa dalla fonte sbagliata, un calo vero classificato come “stabile”, nessun modo di risalire a dove venisse un numero, nessuna vista sull’andamento recente. Ogni nota è diventata una modifica specifica, applicata lo stesso giorno e distribuita a tutti.
La parte che mi interessa di più però è il secondo giro, perché descrive un guasto della terza famiglia. Rieseguendo la skill migliorata sui dati di un altro account è emerso che i controlli non venivano eseguiti sempre tutti: la skill decideva caso per caso quali applicare, quindi il più delle volte ci prendeva e ogni tanto, come scrivono loro, “every so often, it quietly skipped one”.
La correzione non è stata una riformulazione di poche parole ma un cambio di funzionamento: se un controllo non può girare per mancanza di dati lo deve dichiarare esplicitamente, e lo strumento riporta soltanto i controlli che ha effettivamente completato, mai uno che ha saltato. Sulle date pubblicate, la issue numero 9 è stata aperta l’11 maggio e la pull request numero 32 è stata fusa il 15: quattro giorni fra il problema strutturale e la sua chiusura, dentro un solo thread.
Come frase da ricordare la loro è netta: un numero sbagliato è imbarazzante, un modello che decide da solo quali controlli contano è un problema di fiducia destinato a peggiorare. Che è la stessa cosa che ho imparato dal mio verificatore rotto, con la differenza che loro se ne sono accorti in un giro di valutazioni programmate e io in un pomeriggio di rilettura casuale.
✅ Manutenzione automazioni AI da freelance: lo stesso loop, artigianale
Chi lavora da solo non ha un repository di skill condivise né duecento colleghi a valle di ogni modifica, e la tentazione è concludere che quel processo non lo riguarda. Sbagliato: i cinque passi ci sono lo stesso, solo che ognuno è impersonato da qualcosa di più povero. La differenza sta tutta nel fatto che l’ultimo passo, la distribuzione, per me costa zero e vale uno, mentre per loro costa un merge e vale duecento.
| Passo del loop | Come lo fa Seer | Come lo faccio io |
|---|---|---|
| Valutazione dell’output | eval registrata a voce da chi usa la skill | rilettura riga per riga dell’output prima di usarlo |
| Ticket strutturato | trascrizione convertita in issue GitHub | voce datata nel diario di lavoro del vault |
| Lavorazione | agent puntato sulla issue, apre una pull request | sessione dedicata su un solo problema alla volta |
| Approvazione | pull request rivista da due persone | rilettura mia, con verifica che il caso rotto adesso fallisca |
| Distribuzione | merge propagato ai plugin di tutta l’azienda | modifica al file di istruzioni, valida dalla sessione dopo |
Il passo che salta per primo, quando salta, è sempre il secondo. Notare che una cosa non va è facile e capita continuamente; scriverla in un posto che riguarderai è la parte che nessuno fa, ed è la ragione per cui lo stesso difetto viene notato tre volte e corretto zero. Nel mio caso quel posto è un file di log per progetto, con la data in cima e una riga per episodio, che è la stessa struttura di una issue senza il repository attorno. Le sei righe della tabella più sopra esistono solo perché il giorno stesso qualcuno le ha scritte.
L’altra differenza è la ragione per cui questo articolo esiste. Quando la review è la tua rilettura, il pericolo non è la lentezza ma la compiacenza: rileggi una cosa che hai deciso tu, e la trovi ragionevole perché è tua. Il correttivo che uso è meccanico e vale la pena copiarlo. Ogni volta che scrivo o modifico un controllo automatico, prima di fidarmene gli do in pasto un caso che deve fallire. Se passa, il controllo è rotto, e lo scopro in dieci secondi invece che in tre mesi.
📊 Migliorare le skill di Claude Code: cosa ho cambiato dopo il 14 agosto
Una skill, nel vocabolario di Claude Code, è un file di istruzioni scritte che dice all’assistente come si fa una cosa specifica: quale procedura seguire, in quale ordine, cosa controllare prima di dichiarare finito. Non è codice, è una consegna scritta, e come tutte le consegne scritte invecchia. La distribuzione a un team passa dai plugin, che è il pezzo su cui poggia il merge-per-tutti raccontato da Seer.
Migliorare skill Claude Code, in pratica, significa correggere il testo di quella consegna a partire da un fallimento osservato. L’episodio del 14 agosto è il mio esempio migliore, perché la correzione giusta non era quella che sembrava. Il sub-agent che aveva bruciato 272.000 token senza produrre nulla veniva respinto dal controllo sugli accenti, e la reazione istintiva sarebbe stata insegnargli a scrivere meglio l’italiano. La correzione vera è stata cambiare la forma del lavoro: non più un file intero scritto in un colpo, ma una prima scrittura minima e poi modifiche a blocchi. Con i blocchi, il pezzo di testo che fa fallire il controllo si isola al primo tentativo respinto, invece di restare nascosto dentro tremila parole.
Il dettaglio che rende l’episodio utile, e che vale come consegna anche per te, è che in due casi su tre l’errore era vero. Il controllo aveva ragione e lo strumento sopra non riusciva a sfruttarlo, perché il messaggio di errore nominava la categoria del problema e non la sua posizione. Un controllo giusto con una diagnostica povera produce esattamente lo stesso spreco di un controllo sbagliato: questa pagina l’ho scritta proprio così, blocco per blocco, e il primo blocco respinto conteneva una congiunzione scambiata per copula.
Quando un’automazione fallisce, la domanda giusta non è come farla riuscire. Prima viene un’altra: stava fallendo per il motivo giusto, e te lo ha detto abbastanza chiaramente da poterla aggiustare?
Agenti AI che aprono pull request: cosa serve prima di arrivarci
Il passo del loop che oggi non ho, e che è la cosa davvero nuova nel racconto di Seer, è il terzo: agenti AI che aprono pull request da soli a partire da un ticket, senza che nessuno tocchi la tastiera fino alla review. Non è fantascienza, la tecnologia è in mano a chiunque abbia un repository, ma i prerequisiti sono precisi e quasi nessuna PMI li ha in casa.
Servono quattro cose, nell’ordine. Un repository dove lo strumento da migliorare esista come file, e non come configurazione dentro l’interfaccia di un servizio esterno: se il tuo flusso vive dentro una piattaforma che non esporta niente, non c’è nessuna pull request da aprire. Un ticket scritto che descriva il difetto in modo controllabile, che è poi il motivo per cui la trascrizione vocale di Seer passa da un modello prima di diventare issue. Un caso di prova che fallisce prima della modifica e passa dopo, altrimenti la review si riduce a leggere del codice plausibile e dire di sì. Infine una persona che approva, con l’autorità e il tempo per dire di no.
Il quarto punto è quello che salta nelle aziende, non i primi tre. Ho visto flussi automatici perfettamente funzionanti diventare inutili perché nessuno era responsabile di guardarli, e questo è lo stesso principio della griglia con cui in automazione dei processi in una PMI decido cosa dare a uno script, cosa a un modello e cosa lasciare a una persona: senza un nome accanto al passo di approvazione, il loop non è un loop, è un tubo.
Aggiungo la ragione per cui non ho fretta di arrivarci. Con volumi da freelance, la differenza fra un agent che apre una pull request e me che apro una sessione dedicata su un problema si misura in minuti, non in giorni. Il valore di quel passo cresce con il numero di persone a valle della modifica, che nel caso di Seer sono duecento e nel mio caso è uno. Comprare l’infrastruttura di qualcun altro perché fa impressione nelle slide è lo stesso errore di cui parlo nel pezzo su cos’è l’AI slop: scambiare la forma del lavoro per il lavoro.
Il criterio finale: chi guarda l’output, e quando
La manutenzione automazioni AI si riduce a una domanda sola, che vale identica per un’agenzia da duecento persone e per uno script da quaranta righe: chi guarda l’output, con quale frequenza, e cosa succede a quello che nota. Se la risposta è “nessuno, mai, niente”, quello che hai non è un’automazione ma un debito che scade in un momento che deciderà lui.
Le tre cose in cui si riassume la manutenzione automazioni AI, da mettere in piedi prima di aggiungere qualunque strumento nuovo, sono banali e vengono tutte da guasti che ho pagato. Primo: un posto scritto e datato dove finiscono i difetti notati, anche quelli piccoli, anche quelli che pensi di ricordarti. Secondo: per ogni controllo automatico, un caso di prova che deve fallire, provato il giorno in cui lo scrivi e riprovato quando lo modifichi. Terzo: una persona con un nome accanto al passo di approvazione, perché una pull request che nessuno rivede è peggio di una modifica fatta a mano. Il resto, dagli agenti che aprono pull request alla distribuzione automatica, è ottimizzazione di un ciclo che deve già esistere.
Il criterio per capire se il tuo esiste è di dieci secondi: prendi l’ultima cosa che ti ha dato fastidio in un output automatico e chiediti dove sta scritta oggi. Se la risposta è “da nessuna parte”, il primo pezzo da costruire non è tecnico. Se vuoi che a guardare i tuoi flussi automatici sia qualcuno che poi mette anche le mani nel codice, qui trovi come lavoro e da lì puoi scrivermi.
❓ Domande frequenti
Che cosa comprende la manutenzione automazioni AI?
Come faccio ad accorgermi che un'automazione si è rotta in silenzio?
Migliorare skill Claude Code: da dove si comincia in pratica?
Servono agenti AI che aprono pull request per tenere aggiornate le automazioni?
Quanto tempo va messo in preventivo per la manutenzione di un'automazione?
Un loop di feedback come quello di Seer funziona anche in una PMI?
Hai un progetto in testa?
Raccontami cosa ti serve o cosa non funziona. Rispondo entro 24 ore, senza preventivi a scatola chiusa.