Information gain SEO: come si misura (metodo replicabile)
Information gain SEO: la procedura in cinque passi per misurare quanto una pagina aggiunge rispetto ai risultati già in SERP, e come implementarlo in pagina.
Information gain SEO significa una cosa sola e misurabile: quanta informazione nuova e verificabile porta la tua pagina rispetto a quelle che stanno già in SERP sulla stessa query. Non è originalità di stile, non è lunghezza, non è quanto tempo ci hai messo. È un delta, e un delta si calcola.
L’obiezione che mi arriva più spesso è di chi il lavoro lo fa bene: scrivo contenuti curati, verificati, lunghi il giusto, e non vengo scelto né da Google né dall’AI. Quasi sempre la risposta sta in un punto solo, ed è antipatica: il pezzo è corretto e non aggiunge niente. Ricopre lo stesso terreno dei primi dieci risultati con parole diverse. Qui sotto trovi la procedura che uso per misurarlo prima di pubblicare, le soglie oltre cui il delta è solo rumore e come si traduce in pagina.
Cos’è l’information gain (e cosa non è)
La definizione operativa che uso in consulenza sta in una riga: l’information gain è la quantità di informazione nuova e verificabile che un documento aggiunge rispetto all’insieme dei documenti già disponibili sullo stesso argomento. Il soggetto della frase non è il tuo testo: è la differenza fra il tuo testo e quello che il lettore, o il modello, ha già letto altrove.
Il riferimento tecnico è il brevetto Google US11354342B2, Contextual estimation of link information gain, depositato nel 2018 e concesso a giugno 2022. Descrive un meccanismo netto: attribuire a un documento un punteggio in funzione di quanto aggiunge rispetto ai documenti che l’utente ha già visto nella stessa sessione, per riordinare i link successivi da proporgli.
Aggiornamento del 20 agosto 2026: due dettagli del testo brevettuale meritano di essere esplicitati, perché cambiano il modo di lavorare. Primo, il punteggio è per utente e per sessione, non assoluto: la stessa pagina vale molto per chi arriva a freddo sulla query e quasi niente per chi ha appena letto cinque articoli quasi identici, perché il confronto avviene con quello che quel singolo utente ha già visto. Secondo, il confronto è semantico, non lessicale: il meccanismo descritto converte ogni documento in una rappresentazione del suo significato, quindi “il gatto sta male” e “il felino è malato” cadono nello stesso punto, e parafrasare il primo risultato produce per definizione un guadagno pari a zero. Nel testo depositato la definizione è netta: “an information gain score for a given document is indicative of additional information that is included in the given document beyond information contained in other documents that were already presented to the user”.
Qui va detta la cosa che nei pezzi italiani sul tema non ho letto quasi mai: un brevetto concesso non dimostra che quel calcolo giri in produzione. Le aziende brevettano anche meccanismi che non implementano, o che implementano in forma diversa, e Google non ha mai dichiarato l’information gain fra i fattori di ranking. Quello che il documento prova è che il problema, dentro Google, è formulato esattamente in questi termini. Usarlo come prova di un fattore attivo sarebbe disonesto.
Il capitolo precedente di questa serie parlava di AI slop e di cosa Google fa davvero con i contenuti prodotti in scala. Il collegamento fra i due pezzi è diretto: se la sbobba è il problema, l’information gain è la sola proprietà che la rende impossibile da produrre in serie.
Non confonderlo con l’information gain del machine learning
Chi arriva dalla data science conosce già il termine con un altro significato: nell’apprendimento automatico l’information gain è la riduzione di entropia che si ottiene dividendo un dataset su un attributo, il criterio con cui un albero decisionale sceglie dove tagliare. L’intuizione di fondo è la stessa, quanta incertezza tolgo, applicata a un oggetto completamente diverso.
La distinzione non è pedanteria, ha una conseguenza pratica sulla scelta della keyword. Il 18 agosto 2026 ho ricontrollato google.it per “information gain” secco: i risultati sono ancora tutti in accezione machine learning, fra entropia, alberi decisionali e tutorial di classificazione, senza un solo pezzo in accezione SEO nella prima pagina. Per questo la variante che presidio qui è information gain SEO: oggi è la sola formulazione che separa le due intenzioni di ricerca.
✅ Come si misura l’information gain SEO: la procedura in cinque passi
La domanda utile non è se il tuo pezzo sia buono. È quali affermazioni contiene che non stanno già nei risultati contro cui deve competere. Quella differenza si conta, e per contarla servono un foglio di calcolo, un LLM qualsiasi e circa un’ora di lavoro per query. La procedura che segue la applico prima di scrivere, non dopo.
- Definisci la baseline. Prendi i primi 5-10 risultati organici della query target, in incognito e sul dominio del paese giusto, e salvane il testo integrale. Dieci risultati bastano: oltre la prima pagina la ripetizione fra fonti cresce e il campione smette di dirti cose nuove. Annota data e ora, perché la baseline scade in fretta.
- Estrai i claim, uno per riga. Per ogni risultato chiedi a un LLM di elencare le affermazioni fattuali e verificabili, senza riassumere e senza aggiungere: un fatto per riga, con la frase originale accanto. L’LLM qui è un estrattore, non un giudice. Le righe che produce vanno rilette da te, perché una parte sarà opinione travestita da fatto.
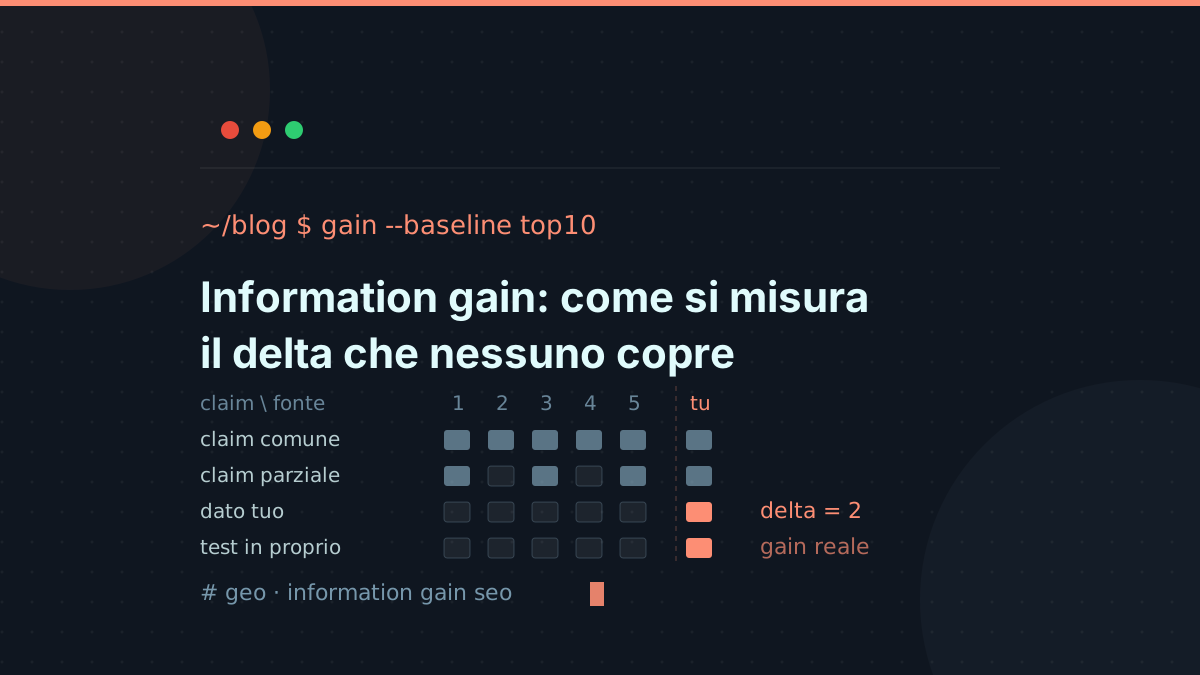
- Costruisci la matrice claim per fonte. Le righe sono i claim deduplicati, le colonne sono le fonti della baseline, le celle contengono un sì o un no. Alla fine hai due informazioni: quali fatti sono presenti ovunque, cioè il minimo sindacale che devi coprire per essere pertinente, e quali compaiono in una fonte sola.
- Misura il delta della tua bozza. Aggiungi una colonna con la tua pagina e riporta i claim che contiene. Il tuo information gain è l’insieme delle righe in cui la tua colonna è l’unica con un sì, a condizione che ogni riga sia vera e verificabile da terzi. Le righe in cui ripeti quello che dicono tutti non sono gain: sono il biglietto d’ingresso.
- Assegna un punteggio, semplice e onesto. Non serve una formula accademica. Conto i claim esclusivi e li peso: 3 se il fatto viene da un dato mio o da una misura che ho fatto, 2 se viene da una fonte primaria che nessuno in baseline ha citato, 1 se è una precisazione o un limite che tutti danno per scontato. Somma la colonna e confrontala con quella della fonte migliore della baseline.
Il valore del metodo non sta nel numero finale, che è arbitrario e lo dichiaro. Sta nelle due cose che ti costringe a guardare: quante righe della tua bozza esistono già identiche altrove, e se il punteggio sopravvive quando togli tutto quello che non riesci a dimostrare. Quasi sempre la prima stesura di un articolo, misurata così, ha un delta vicino a zero.
Se un modello linguistico può scrivere il tuo pezzo senza sapere niente di te, dei tuoi clienti e dei tuoi dati, il tuo information gain è zero: hai riscritto la media della prima pagina.
🛠️ Soglie e falsi positivi: cosa non conta come gain
La parte che fa perdere tempo non è trovare differenze, è scartare quelle finte. Nella matrice del punto 3 si accumulano righe che sembrano gain e non lo sono, e riconoscerle è metà del lavoro.
Non conta come gain una riformulazione: dire “tempo di risposta del server” dove gli altri scrivono TTFB aggiunge zero informazione, aggiunge solo un sinonimo. Non conta un’opinione non verificabile: “secondo noi la struttura migliore è questa” non è un fatto, è una preferenza, e nella matrice va marcata come tale.
Non conta un dettaglio non falsificabile: se un’affermazione non ammette un modo per essere smentita, non porta informazione. Non conta, infine, un fatto vero ma irrilevante per la query: la lunghezza in più che non risponde a niente conta come rumore, non come delta.
La soglia che uso è volutamente grezza: sotto le tre righe esclusive con peso 2 o 3, la pagina non va pubblicata come pezzo nuovo. Va accorpata a una esistente, oppure va rimandata finché non ho un dato mio da metterci dentro. Non è una soglia scientifica, è una regola che mi impedisce di pubblicare per riempire un calendario editoriale.
Due limiti del metodo, dichiarati perché li ho incontrati. Il primo: l’estrazione dei claim è sensibile al prompt, e lo stesso testo dato a due modelli diversi produce liste con un numero di righe diverso. Vanno tenuti fissi il modello e la formulazione per tutta la baseline, altrimenti stai confrontando misure prese con righelli diversi. Il secondo: nessun LLM è affidabile nel decidere se un claim è vero, quindi la verifica finale resta manuale e sulla fonte primaria. Il metodo riduce il lavoro di lettura, non quello di controllo.
Dove trovare gain se non fai ricerca originale
L’obiezione successiva è sempre la stessa: non ho un laboratorio, non pubblico studi, vendo ricambi. Vale il contrario di quello che sembra. Un’azienda che opera da anni ha già in casa dati che nessun concorrente in SERP possiede, e in genere non li ha mai considerati contenuto.
Il primo giacimento sono i dati gestionali. Quante volte un articolo viene reso e per quale motivo, quali taglie o misure sbagliano più spesso i clienti, quanto dura davvero un ricambio nell’uso reale, quali combinazioni di prodotti vengono comprate insieme. Sono numeri che non richiedono ricerca, richiedono una query sul database e la decisione di renderli pubblici in forma aggregata.
Il secondo sono i ticket di assistenza. Le domande che il servizio clienti riceve ogni settimana sono, alla lettera, le domande che il mercato fa e che nessuna pagina in SERP risponde nel modo in cui vengono poste. Sono anche la fonte più onesta di long tail: le persone scrivono ai fornitori con le stesse parole con cui interrogano un motore.
Il terzo è l’esperienza applicata: il caso in cui l’indicazione standard non ha funzionato e cosa hai fatto al posto suo. È il tipo di informazione che manca strutturalmente ai contenuti scritti da chi il lavoro non lo fa, e nella matrice del punto 3 produce righe con peso 3. Se hai un e-commerce, questi tre giacimenti sono già dentro la tua azienda: il costo non è raccoglierli, è decidere di scriverli.
🛠️ Come si mette in pagina: chunk, heading, tabelle
Avere il delta non basta: va scritto in modo che un sistema di retrieval lo possa isolare. La regola che seguo è una sola e ha effetti visibili: un fatto verificabile per chunk, dove per chunk intendo il blocco di testo compreso fra un heading e il successivo, o il singolo elemento di una lista.
In pratica significa tre cose. Gli heading sono domande reali, formulate come le pone un cliente, non etichette da sommario: una domanda in H2 o H3 dice al sistema quale porzione risponde a cosa. I dati stanno in tabelle o liste, non annegati in un periodo lungo, perché una riga di tabella con soggetto, valore e unità è estraibile senza ambiguità mentre una subordinata non lo è. Ogni affermazione forte porta accanto la sua fonte o la sua provenienza, “misurato su”, “dato interno di”, “in questi casi ho osservato”.
Su un e-commerce PrestaShop questo si traduce in due posti concreti. Le schede prodotto, dove il gain sta nei campi che nessuno compila: misure reali verificate, compatibilità testate, durata osservata, motivo dei resi. E il blocco FAQ, che va costruito dai ticket di assistenza veri invece che dalle domande inventate a tavolino, perché è lì che vive la formulazione autentica delle domande. Ho scritto altrove come si scrivono descrizioni prodotto che l’AI indicizza e la checklist dei contenuti per AI Mode, che sono il livello di dettaglio operativo sotto questo.
Su un sito statico in Astro il ragionamento non cambia, cambia il posto dove lo imposti: heading generati dalle domande, componenti dedicati per callout e FAQ in modo che i blocchi restino separati nel markup, e dati strutturati emessi dallo stesso sorgente del testo, così che la versione leggibile e quella per le macchine non divergano mai.
📊 Come si misura dopo la pubblicazione
La misura pre-pubblicazione dice se il pezzo aggiunge qualcosa. Solo i dati dopo dicono se quel qualcosa è stato riconosciuto, e sono tre segnali distinti, da leggere insieme.
Il primo, in Search Console, sono le query nuove non target: se dopo qualche settimana la pagina raccoglie impression su domande che non avevi in piano, ha coperto un’area informativa che le altre fonti non coprivano. È il segnale più affidabile che il delta esisteva davvero, molto più della posizione sulla chiave principale.
Il secondo è la distribuzione delle impression sulle query lunghe: un contenuto con gain reale tende ad allargarsi sulla coda invece di concentrarsi su due o tre chiavi. Il terzo sono le citazioni nelle risposte AI, che vanno cercate fuori dal tuo sito: quando ho analizzato dove nascono le citazioni AI il quadro era netto, circa l’85% delle fonti citate sono siti terzi e non il sito del brand. Un fatto tuo che vale davvero viene ripreso da altri, ed è quel rimbalzo che poi torna in citazione.
La finestra minima per leggere questi tre segnali è di trenta giorni, confrontati con i trenta precedenti a parità di stagionalità: su periodi più corti il rumore delle impression copre il delta. Questo articolo è a sua volta un banco di prova della procedura: la baseline della sua query l’ho verificata il 18 agosto 2026, prima di scrivere, e verrà misurato con gli stessi tre segnali. I numeri, quando ci saranno, finiranno qui in un aggiornamento datato.
Information gain e AI search: perché una fonte viene citata
Nei motori generativi il meccanismo di selezione rende il delta ancora più decisivo. Un sistema che recupera passaggi e li sintetizza deve scegliere quali frammenti mettere nella risposta, e a parità di pertinenza tende a prendere quelli che portano un elemento che gli altri non hanno: un numero, una data, una condizione, un limite dichiarato. Dieci pagine che dicono la stessa cosa sono, per il retrieval, una pagina sola replicata dieci volte.
Da qui discende una conseguenza che vedo ancora ignorata: ottimizzare per le risposte AI non significa scrivere di più, significa scrivere meno cose ma non ricavabili altrove, e metterle in blocchi che si possono citare senza riscriverli. La guida ufficiale di Google sulle funzionalità generative dice sostanzialmente questo quando parla di contenuto utile e originale come precondizione: il resto sono conseguenze tecniche. Il quadro completo di come funziona la selezione delle fonti sta nel pezzo su cos’è la GEO.
Il criterio finale: il test di sostituibilità
Se dovessi ridurre tutto a un controllo solo, userei questo: prendi la tua pagina, togli il nome del brand e chiediti se un modello linguistico avrebbe potuto scriverla senza sapere niente di te, dei tuoi clienti e dei tuoi numeri. Se la risposta è sì, l’information gain è zero, e nessuna quantità di ottimizzazione tecnica compenserà quel vuoto. Se la risposta è no, hai qualcosa: il lavoro che resta è renderlo estraibile.
La procedura in cinque passi serve a rendere quella domanda meno soggettiva e ripetibile da chiunque, anche da chi non ha strumenti a pagamento. Applicala prima di scrivere, non dopo: misurare l’information gain SEO a bozza finita significa quasi sempre buttare via la bozza e ricominciare.
Il capitolo precedente di questa serie raccontava il lato opposto della stessa medaglia, cioè cosa succede a chi pubblica senza chiedersi mai cosa sta aggiungendo. Se invece ti serve un quadro più largo di come i motori generativi scelgono le fonti da citare, e di cosa cambiare sulle tue pagine perché ci finiscano dentro, è il lavoro che faccio nella consulenza GEO.
❓ Domande frequenti
Come si misura l'information gain di un contenuto?
Esiste una formula ufficiale o un punteggio di information gain?
Quali strumenti servono per calcolare l'information gain?
Qual è la soglia sufficiente per pubblicare una pagina nuova?
Come si misura su una pagina già online che voglio rifare?
L'information gain è un fattore di ranking confermato da Google?
Hai un progetto in testa?
Raccontami cosa ti serve o cosa non funziona. Rispondo entro 24 ore, senza preventivi a scatola chiusa.